Neuigkeiten
Hier finden Sie eine Übersicht der neuesten Funktionen und Verbesserungen in feld.ai.
September 2026 — KW 37 (7.–11. September)
Schwärzung erkennt jetzt auch Logos und andere Grafiken
Bisher fand die Schwärzung nur Text: Erkannt wurde, was die Texterkennung als Wörter gelesen hatte. Ein Firmenlogo, ein Stempel oder ein Siegel besteht aber aus Bildpunkten und nicht aus Wörtern — solche Elemente ließen sich deshalb weder automatisch finden noch schwärzen.
Jede Kategorie Ihres Schwärzungssets hat dazu jetzt eine Erkennungsart: Text durchsucht wie bisher die erkannten Wörter, visuell sucht das Element auf dem Seitenbild. Welche Kategorie wie erkannt wird, sehen Sie in den Projekteinstellungen im Tab Schwärzung; eingerichtet wird es von Ihrer Administration.
Ein Klick auf Erkennen startet beide Durchläufe gemeinsam. Ein Fortschrittsbalken zeigt, wie weit die Erkennung ist — die visuelle Suche dauert länger als die Textsuche. Die Ergebnisse erscheinen anschließend zusammen, aufgeteilt in die Abschnitte Text und Figuren. Vorschau und Download behandeln beide Arten gleich: Was Sie in der Ansicht Geschwärzt sehen, entspricht dem heruntergeladenen PDF.
Hinweis: Visuelle Treffer werden nicht dauerhaft gespeichert. Laden Sie das Dokument neu, starten Sie die Erkennung für diese Kategorien bitte erneut.
Extrahierte Werte mit Referenzdaten abgleichen
Extrahierte Werte lassen sich jetzt in jedem Projekt mit einem Referenzdatensatz abgleichen — etwa eine extrahierte Kundennummer mit Ihrer Mandantenliste. Bisher war ein Abgleich nur über die Rechnungsabgleich-Konfigurationen möglich. In den Projekteinstellungen gibt es dafür im Tab Extraktion den neuen Bereich Abgleich mit einem Schalter. Ist er eingeschaltet, legen Sie über Matcher hinzufügen fest, welcher Referenzdatensatz verwendet wird und welche Schemafelder mit welchen Spalten verglichen werden; Abgleich speichern übernimmt die Einstellung.
Das Ergebnis erscheint in der Dokumentansicht im Tab Ergebnisse als Kennzeichen am abgeglichenen Wert: Zugeordnet, Abgleich prüfen (mehrere Kandidaten liegen nah beieinander) oder Keine Zuordnung. Ein Klick darauf zeigt die gefundenen Kandidaten mit Punktzahl sowie Name und Version des Referenzdatensatzes. Schalten Sie den Abgleich aus, werden die Matcher entfernt; die Extraktion selbst läuft weiter. Mehr dazu unter Auto-Extraktion.
Chat: zuverlässigere Antworten zu Rechtstexten
Der Chat beantwortet Fragen zu Gesetzen, Reglementen und Beschlüssen jetzt deutlich zuverlässiger. Tabellen — etwa Synopsen und Änderungstabellen — bleiben beim Einlesen zeilenweise lesbar, statt spaltenweise zerrissen zu werden, und Abschnittsmarken am Seitenrand gehen nicht mehr verloren.
Zu jedem Erlass kennt der Chat jetzt Beschluss- und Inkrafttretensdatum sowie den Stand und nennt in der Antwort die zutreffende Fassung. Liegen mehrere Fassungen desselben Erlasses vor, prüft er die Anwendbarkeit auch dann, wenn die Frage kein Datum nennt, und stützt sich bevorzugt auf die geltende Fassung; frühere Fassungen zieht er vor allem für Vergleiche oder Fragen zur Entstehungsgeschichte heran. Antworten auf Fragen wie „Welche Beschlüsse nennen …?" zählen jedes Dokument nur einmal, belegen Nennungen einer bestimmten Norm oder Aktennummer mit einer wörtlichen Fundstelle und zitieren Beschlüsse nach Erwägung (z. B. „Erwägung 7").
In großen Projekten findet der Chat das maßgebende Dokument zuverlässiger: Umfangreiche Dokumente verdrängen andere nicht mehr aus der Vorauswahl, und Textstellen werden auch über ihre Themenüberschrift gefunden (z. B. „§ 11 Massgebendes Terrain"), selbst wenn der Text die Begriffe der Frage nicht enthält. Dieselbe Frage liefert außerdem weitgehend dieselben Quellen — bisher konnte die Auswahl von Mal zu Mal deutlich abweichen.
Hinweis: Lesbare Tabellen, Abschnittsmarken, Erlassdaten und Themenüberschriften gibt es nur für Dokumente, die nach der Umstellung verarbeitet wurden. Ältere Bestände müssen dafür erneut verarbeitet werden.
Nach der Anmeldung direkt im Projekt
Sie landen nach der Anmeldung jetzt in Ihrem zuletzt geöffneten Projekt statt in der Projektübersicht. Beim ersten Login öffnet feld.ai Ihr ältestes Projekt. Ist der Chat für das Projekt aktiviert, öffnet sich Projektwissen, sonst die Dokumentenliste. Gehört Ihnen noch kein Projekt, erscheint wie bisher die Projektübersicht — und Sie erreichen sie jederzeit über Projekte in der Seitenleiste. Während das Projekt geladen wird, zeigt die Anmeldung einen Ladebalken.
Weitere Neuigkeiten
- 2026-09-09 – Externe API: Extraktions-Jobs akzeptieren zwei neue Optionen.
return_confidence_scoreliefert im Ergebnis zu jedem Wert einen Konfidenzwert des Modells (auch innerhalb von Listen),return_bboxdie Fundstelle (Seite und Koordinaten) — beide unabhängig voneinander. Siehe API-Referenz. - 2026-09-09 – Der Chat lässt sich in ein externes Dokumentenmanagementsystem einbetten: Das Host-System meldet Nutzer per signiertem Token an, eine separate Anmeldung bei feld.ai entfällt. Die Einrichtung übernimmt feld.ai.
- 2026-09-07 – Extraktion: Fundstellen für grafische Elemente (Logos, Stempel, Abbildungen) sitzen jetzt genau auf dem Element — bisher war die Markierung sichtbar versetzt. Gilt bei Extraktionen mit Fundstellen.
- 2026-09-07 – Schwärzung: Der Bereich in der Dokumentansicht ist übersichtlicher gegliedert; die Trefferliste lässt sich einklappen.
Weitere Neuigkeiten
- 2026-09-05 – Chat: Werden Dokumente eines Projekts noch verarbeitet, zeigt das Chatfenster jetzt über dem Eingabefeld einen Hinweis („3 von 12 Dokumenten werden noch vorbereitet") — Antworten können diese Dokumente noch nicht berücksichtigen. Dokumente, die nicht vorbereitet werden konnten (etwa weil die Verarbeitung fehlschlug oder der Chat zum Zeitpunkt der Verarbeitung ausgeschaltet war), werden gesondert ausgewiesen; sie fließen erst nach einer erneuten Verarbeitung in Antworten ein.
Verbesserungen
- 2026-09-09 – Rechnungsabgleich: In einer Konfiguration blieb die Reihenfolge der Extraktionsfelder nach dem Speichern nicht erhalten — beim erneuten Öffnen erschienen sie in anderer Reihenfolge. Bestehende Konfigurationen übernehmen die gewünschte Reihenfolge beim nächsten Speichern.
- 2026-09-09 – Fälle (Beta): Die Falltyp-Tabs in der Fallübersicht wurden über die gesamte Breite gestreckt.
- 2026-09-08 – Dokumentansicht: Im Tab Ergebnisse wurden Zahlen immer im englischen Format angezeigt (
2,575.7), unabhängig von der eingestellten Sprache. Sie folgen jetzt der Oberflächensprache — auf Deutsch also2.575,7. Während Sie eine Zahl bearbeiten, bleibt Ihre Eingabe unverändert stehen; formatiert wird sie, sobald Sie das Feld verlassen. - 2026-09-07 – Dokumentliste: Kategorienfilter und Filter-Formular ergänzten sich bisher, statt einander einzuschränken — ein zusätzlich gewählter Kategorienfilter vergrößerte die Trefferliste. Beide werden jetzt mit UND verknüpft. Kategorienfilter und Ordner bleiben zudem beim Laden einer gespeicherten Abfrage erhalten.
- 2026-09-07 – Chat: Belegt die Antwort mehrere Stellen derselben Dokumentseite, erscheint dafür jetzt eine einzige Quellenkarte, die alle Markierungen enthält — statt mehrerer Karten mit demselben Seitenverweis. Erstreckt sich eine Stelle über einen Seitenumbruch, bleibt sie eine eigene Karte.
August/September 2026 — KW 36 (31. August – 4. September)
Ordner löschen: Inhalte behalten oder mitlöschen
Beim Löschen eines Ordners fragt feld.ai jetzt, was mit dem Inhalt geschehen soll — bisher wurden die Dokumente immer in den Projekt-Root verschoben. Der Dialog zeigt zunächst, wie viele Unterordner und Dokumente betroffen sind, und bietet bis zu drei Möglichkeiten: Inhalte behalten rückt Unterordner und Dokumente samt Struktur in den übergeordneten Ordner bzw. in den Projekt-Root. Nur die Dokumente behalten legt alle Dokumente flach im Projekt-Root ab und löscht die Unterordner. Ordner mit allen Inhalten löschen entfernt den Ordner samt Unterordnern und Dokumenten; die Schaltfläche heißt hier Endgültig löschen. Ein leerer Ordner wird nach einer einfachen Bestätigung gelöscht.
Achtung: Mit Ordner mit allen Inhalten löschen gelöschte Dokumente lassen sich nicht wiederherstellen.
Weitere Neuigkeiten
- 2026-09-05 – Fälle (Beta): Eine leere Fallübersicht führt jetzt weiter — Ersten Fall erstellen, wenn im Projekt noch kein Fall existiert, und Filter zurücksetzen, wenn Filter, Suche oder eine gespeicherte Ansicht alle Fälle ausblenden. Sind für das Projekt keine Falltypen definiert, erklärt die Seite das an Ort und Stelle; der Hinweis an der Schaltfläche Neuer Fall lässt sich jetzt auch im deaktivierten Zustand aufrufen.
- 2026-09-05 – Dokumentansicht: Der Bereich Workflow-Status listet jetzt alle Verarbeitungsschritte eines Dokuments (Klassifizierung, Extraktion, Zusammenfassung, Aufteilung, Rechnungsverarbeitung) statt nur benutzerdefinierter Workflows. Zu einem fehlgeschlagenen Schritt erscheint die Fehlermeldung. Fehlgeschlagene automatische Workflow-Schritte (Klassifizierung, Extraktion, Pipeline) starten Sie über Erneut versuchen neu, ohne das Dokument erneut hochzuladen.
- 2026-09-04 – Fälle (Beta): In der Detailansicht eines Falls lässt sich die Seitenleiste mit den Falldetails ein- und ausklappen — über die Schaltfläche Falldetails oder mit Strg/Cmd +
\. Der Zustand bleibt erhalten.
Verbesserungen
- 2026-09-05 – Fälle (Beta): Die Fallübersicht meldete „Noch keine Fälle", obwohl Filter, Suche oder eine gespeicherte Ansicht die Liste nur eingeschränkt hatten oder die Falltypen noch geladen wurden. Ließen sich die Falltypen nicht laden, sah die Seite ebenfalls wie ein leeres Projekt aus — jetzt erscheint eine Fehlermeldung. Beim Wechsel des Falltyp-Tabs bleiben zudem keine Sucheingaben mehr stehen.
- 2026-09-04 – Rechnungsabgleich: Rechnungen mit sehr vielen Positionen (ab etwa 150) schlugen beim Abgleich mit dem Modell fehl. Die Anfragen werden jetzt passend aufgeteilt.
- 2026-09-04 – Schwärzung: Die Markierungen aus dem Tab Schwärzung blieben nach einem Tabwechsel auch in den übrigen Tabs der Dokumentansicht sichtbar. Beim Verlassen des Tabs wird jetzt die zuvor gewählte Klassifizierungsregel wiederhergestellt.
- 2026-09-01 – Einzelne Outlook-E-Mails (.msg), deren interne Angabe zur Zeichenkodierung nicht zum tatsächlichen Inhalt passte, schlugen bei der Verarbeitung fehl. Solche Dateien werden jetzt verarbeitet.
August 2026 — KW 35 (24.–28. August)
Fundstellen für praktisch jeden extrahierten Wert
Extraktionen mit Metadaten liefern jetzt zu nahezu jedem Wert eine Fundstelle im Dokument — bisher blieb ein Großteil der Werte ohne Markierung. Auch abgeleitete Werte (z. B. „Ja" oder „3 Monate") werden verortet: Markiert wird dann die Stelle, aus der der Wert geschlossen wurde. Bezieht sich ein Wert auf eine ganze Seite, markiert die Fundstelle die gesamte Seite.
Werte aus mehrseitigen Dokumenten landen zudem auf der richtigen Seite. Bisher konnte die Fundstelle bei Listen und Tabellen auf eine benachbarte Seite verweisen. Fehlt eine Fundstelle, wurde im Dokument keine Stelle gefunden, die den Wert belegt.
Weitere Neuigkeiten
- 2026-08-28 – Rechnungsabgleich: Ein Identifikator (z. B. eine Bestellnummer) grenzt die Kandidaten jetzt ein, statt allein zu entscheiden — mehrere Zeilen mit demselben Schlüssel werden über die übrigen Felder unterschieden. Ein abweichender oder falsch erkannter Identifikator schließt eine Zeile nicht mehr aus. Außerdem entspricht die Punktzahl eines Treffers jetzt der Sicherheit des Modells, und die Standardschwelle steigt von 0,5 auf 0,7 — unsichere Treffer werden seltener angezeigt.
- 2026-08-27 – Fälle (Beta): Der Dialog zum Hinzufügen eines Dokuments zu einem Fall hat jetzt eine Suche, und schlägt das Nachladen weiterer Fälle fehl, lässt es sich über Erneut versuchen wiederholen. In der Fallübersicht heißt die Spalte Mitgl. jetzt Dokumente.
- 2026-08-27 – Fälle (Beta): Ob Falldokumente, Notizen und Checkliste in der Seitenleiste eines Falls ein- oder ausgeklappt sind, bleibt jetzt erhalten.
- 2026-08-26 – Fälle (Beta): In der Fallübersicht steht die Spalte Notiz jetzt hinter Bearbeiter, und Geändert zeigt zusätzlich die Uhrzeit.
- 2026-08-26 – Fälle (Beta): In der Dokumentansicht eines Falls werden jetzt alle Kategorien eines Dokuments angezeigt statt nur zwei; Kategorien mit eigener Farbe stehen vorn.
- 2026-08-26 – Projekteinstellungen: Alle Tabs haben jetzt ein einheitliches Layout mit Überschrift und Kurzbeschreibung je Bereich.
- 2026-08-24 – Fälle (Beta): In der Detailansicht eines Falls blenden Sie über Kategorien anzeigen die Kategorien aller Dokumente ein.
Verbesserungen
- 2026-08-26 – Das Herunterladen mehrerer Dokumente als ZIP schlug ab etwa 100 ausgewählten Dokumenten mit einem Serverfehler fehl.
- 2026-08-24 – Projekteinstellungen: Beim Wechsel auf einen Tab werden die Daten jetzt neu geladen. Neu angelegte Klassifizierungsregeln oder Extraktionsschemas waren bisher erst nach einem Neuladen der Seite sichtbar.
August 2026 — KW 34 (17.–21. August)
Fall-Chat: Fragen an alle Dokumente eines Falls
Diese Funktion wird projektweise aktiviert. Das Fallfeature befindet sich weiterhin in der Beta-Phase.
Die Detailansicht eines Falls hat jetzt einen Fall-Chat. Sie öffnen ihn über die Schaltfläche Fall-Chat und stellen Fragen zu allen Dokumenten des Falls, ohne sie einzeln zu öffnen — etwa „Welche Fristen sind in diesem Fall genannt?" oder „Fasse den Sachverhalt zusammen."
Der Assistent arbeitet dabei sichtbar: Über der Antwort steht, was er gerade tut (z. B. Fall wird durchsucht, Extraktion wird gelesen, Dokument wird zusammengefasst). Er kann auf Wunsch auch Arbeitsschritte auslösen — Klassifizierung, Extraktion, Zusammenfassung, eine Pipeline oder die vollständige Neuverarbeitung eines Dokuments. Die Antwort erscheint fortlaufend, mit Stopp brechen Sie sie ab, mit Neuer Chat beginnen Sie von vorn. Absenden mit Enter, ein Zeilenumbruch mit Shift+Enter.
Der Chat beantwortet Fragen in erster Linie aus den Dokumenten des jeweiligen Falls. Findet er dort nichts oder fragen Sie ausdrücklich nach Dokumenten außerhalb des Falls, kann er auch im übrigen Projekt suchen. Bei einer Störung erscheint eine verständliche Meldung statt eines leeren Ergebnisses. Unterhaltungen werden noch nicht gespeichert: Ein Wechsel der Seite oder ein Neuladen startet den Chat neu.
Projektnavigation mit festen Bereichen
Jedes Projekt hat jetzt eine durchgehende Kopfzeile mit dem Projektnamen und den Bereichen Dokumente, Fälle, Referenzdaten und Einstellungen — auf jeder Seite an derselben Stelle, mit Hervorhebung des aktuellen Bereichs. Sie ersetzt das bisherige Drei-Punkte-Menü (⋮), in dem diese Ziele versteckt waren. Fälle erscheint nur in Projekten, in denen das Fallfeature aktiviert ist.
Die Aktionen der jeweiligen Seite (z. B. Frage stellen und + Neu unter Dokumente oder Neuer Fall unter Fälle) stehen in derselben Kopfzeile. Innerhalb eines Ordners zeigt eine kleine Pfadleiste, wo Sie sich befinden. Die frühere eigene Playground-Seite gibt es nicht mehr: Den Playground öffnen Sie jetzt in der Dokumentansicht über das Symbol Playground (Reagenzglas) in der Werkzeugleiste — er bezieht sich damit immer auf das geöffnete Dokument. Mehr dazu unter Playground.
Referenzdaten in der Oberfläche anlegen und herunterladen
Referenzdatensätze lassen sich jetzt vollständig in der Oberfläche verwalten — bisher war dafür die feld.ai External API nötig, die Seite war nur lesbar.
Über Neuer Datensatz legen Sie einen Datensatz aus einer CSV-Datei an
(bis 50 MB). Zeichensatz und Trennzeichen (Komma, Semikolon, Tabulator,
senkrechter Strich) werden automatisch erkannt, Spaltentypen abgeleitet; nur
leere Zellen werden zu Leerwerten, Texte wie NA bleiben erhalten. Über das
Menü eines Datensatzes laden Sie eine neue Version hoch, ändern Name und
Beschreibung oder löschen den Datensatz. Fehler werden direkt im Dialog
erklärt — etwa ein bereits vergebener Name oder eine Spalte, die gegenüber der
Vorversion fehlt.
Jede Version lässt sich in der Versionshistorie zusätzlich als CSV herunterladen, auch wenn sie für die Vorschau im Browser zu groß ist. Die Datei öffnet sich direkt in Excel. Mehr dazu unter Referenzdaten verwalten.
Chat pro Projekt ein- und ausschalten
Der Chat steht nur zur Verfügung, wenn er für Ihre Organisation freigeschaltet ist.
Der Chat lässt sich jetzt je Projekt ein- und ausschalten. In den Projekteinstellungen gibt es dafür den neuen Tab Chat mit einem Schalter; Änderungen gelten sofort. Beim Anlegen eines Projekts legen Sie über die neue Option Chat aktivieren fest, ob der Chat von Beginn an eingeschaltet ist — neue Projekte starten ohne Chat. In bestehenden Projekten bleibt der Chat eingeschaltet.
Ist der Chat ausgeschaltet, wird er im Projekt ausgeblendet, und Dokumente werden bei der Verarbeitung nicht für den Chat vorbereitet. Das spart Verarbeitungsaufwand in Projekten, die den Chat nicht benötigen.
Hinweis: Dokumente, die hochgeladen wurden, während der Chat ausgeschaltet war, sind im Chat nicht verfügbar — auch nach dem Einschalten nicht. Erst danach hochgeladene Dokumente werden wieder automatisch für den Chat vorbereitet.
Weitere Neuigkeiten
- 2026-08-21 – Externe API: Klassifikationsergebnisse enthalten jetzt zusätzlich den Konfidenzwert des Modells (
metadata.document_type.confidence) — siehe API-Referenz. - 2026-08-21 – Externe API: Fehlermeldungen zu ungültigen Anfragen geben den eingesendeten Wert nicht mehr zurück.
- 2026-08-18 – Seitenleiste: Die Kopfzeile der Ordnerliste ist jetzt ein einziges Klickziel — ein Klick öffnet die Liste, ein weiterer klappt sie ein, ohne die Seite zu wechseln.
- 2026-08-18 – Extraktion: Werte, die im Dokument nicht lokalisiert werden konnten, liefern keine Platzhalter-Fundstelle (
0,0,0,0) mehr, sondern gar keine Angabe.
Verbesserungen
- 2026-08-21 – Kategorienfilter: Auch die Dokumentliste selbst folgt jetzt dem geöffneten Ordner samt Unterordnern — bisher galt die Ordnereinschränkung nur für die Anzahl je Kategorie.
- 2026-08-21 – Fehlgeschlagene Verarbeitungsschritte nennen jetzt einen konkreten Grund (z. B. dass eine PDF-Datei beschädigt oder unvollständig ist) statt einer allgemeinen Fehlermeldung.
- 2026-08-20 – Fälle (Beta): In Projekten mit mehreren Extraktionsschemas hing es vom Zufall ab, welche Werte in der Falldetailansicht und beim Anlegen eines Falls übernommen wurden — jetzt gewinnt der zuletzt geänderte Datensatz.
- 2026-08-20 – Dokumentansicht: Fundstellen zu verschachtelten Feldern werden wieder korrekt hervorgehoben, und die Ansicht springt zur passenden Seite.
- 2026-08-20 – Kategorienfilter: Die Anzahl je Kategorie bezieht sich jetzt auf den geöffneten Ordner samt Unterordnern statt auf das gesamte Projekt.
- 2026-08-20 – Sehr grafiklastige PDF-Seiten (z. B. Lagepläne) blockierten die Verarbeitung; sie werden jetzt per Texterkennung gelesen.
- 2026-08-19 – Dokumentliste und Excel-Export zeigten leere Felder, obwohl Werte extrahiert waren — betroffen waren Projekte mit mehreren Extraktionsschemas.
- 2026-08-19 – Eine Extraktion, die ohne jedes Ergebnis abbricht, wird jetzt als fehlgeschlagen angezeigt statt als abgeschlossen mit leerem Ergebnis; vorübergehende Störungen werden vorher automatisch wiederholt.
- 2026-08-19 – Playground: Bei fünf Tabs war der letzte in schmalen Fenstern nicht mehr erreichbar.
- 2026-08-18 – Fälle (Beta): Das Anordnen nach einem extrahierten Datumsfeld sortiert jetzt chronologisch statt alphabetisch.
- 2026-08-18 – Extraktion langer Dokumente: Fehlgeschlagene Teilschritte werden wiederholt, statt einzelne Seiten stillschweigend ohne Beschreibung zu lassen.
August 2026 — KW 33 (10.–14. August)
CSV-Dateien hochladen
Sie können jetzt CSV-Dateien (.csv) hochladen. Beim Hochladen wird die Datei
in eine Excel-Datei mit einem Tabellenblatt umgewandelt und danach genau wie
eine Excel-Datei verarbeitet — mit Tabellenansicht, Tabellenextraktion und
Extraktion. Das heruntergeladene Dokument ist entsprechend eine .xlsx-Datei.
Alle Werte werden als Text übernommen. Führende Nullen (007), lange
Nummern und Datumsangaben in Schreibweisen wie 01/02/2024 bleiben damit
unverändert erhalten. Trennzeichen (Komma, Semikolon, Tabulator, senkrechter
Strich) und die gängigen Zeichensätze werden automatisch erkannt.
CSV-Dateien dürfen bis zu 50 MB gross sein. Sehr grosse Tabellen werden mit einer klaren Meldung abgelehnt, statt beim Verarbeiten stillschweigend gekürzt zu werden. CSV-Anhänge in E-Mails werden gleich behandelt wie direkt hochgeladene Dateien.
Textdateien mit Kommas
Textdateien (.txt), deren Zeilen Kommas enthalten, wurden bisher beim
Hochladen abgelehnt. Sie werden jetzt korrekt als Textdatei erkannt und
verarbeitet.
Schwärzung: eigener Tab mit Vorschau und Vergleich
Diese Funktion wird projektweise aktiviert und befindet sich noch in einer frühen Phase.
Die Schwärzung hat in der Dokumentansicht jetzt einen eigenen Tab Schwärzung. Er ersetzt die beiden bisherigen Aktionen PII erkennen und Geschwärztes PDF herunterladen in der Werkzeugleiste. Der Tab erscheint bei PDF-Dokumenten, sobald für das Projekt ein Kategorienset für die Schwärzung hinterlegt ist. Dort wählen Sie die Kategorien aus, die erkannt werden sollen — je Kategorie zeigt eine Zahl die gefundenen Treffer. Unter Eigene Begriffe ergänzen Sie eigene Suchbegriffe, einen pro Zeile; sie werden wörtlich erkannt, Groß- und Kleinschreibung spielt keine Rolle.
Für die Prüfung stehen drei Ansichten bereit: Original, Geschwärzt und Vergleich mit einem verschiebbaren Trenner zwischen beiden Fassungen. Darunter listet Treffer alle Fundstellen nach Kategorie auf; ein Klick springt zur passenden Seite. Nehmen Sie eine Kategorie aus der Auswahl, gilt das sofort für die Ansicht und für den Download — das heruntergeladene PDF entspricht damit dem, was Sie auf dem Bildschirm sehen.
Hinweis: Die Ansichten Geschwärzt und Vergleich sind eine Vorschau. Dauerhaft entfernt werden Text und Bildpunkte erst im heruntergeladenen PDF.
In den Projekteinstellungen gibt es ebenfalls einen Tab Schwärzung. Dort sehen Sie die Kategorien des Projekts, gelangen über Kategorien bearbeiten zum Kategorienset und hinterlegen unter Standardbegriffe für die Schwärzung Begriffe, die bei jedem Durchlauf vorgeschlagen werden.
Zwei neue Playground-Tabs: Zusammenfassung und Rechnung
Der Playground hat zwei zusätzliche Tabs. Unter Zusammenfassung erzeugen Sie die Zusammenfassung eines Dokuments und steuern sie über Sprache, Maximale Wortanzahl (Standard: 200) und optionale Anweisungen, für die es auch Vorlagen gibt. Das Ergebnis nennt Wortanzahl und Sprache. Verwendet werden nur die ersten drei Seiten des Dokuments; Excel-Dokumente werden hier nicht unterstützt.
Unter Rechnung testen Sie Ihre Rechnungsabgleich-Konfigurationen an echten Dokumenten. Sie laden eine Konfiguration des Projekts, passen sie direkt im Tab an und führen sie aus. Das Ergebnis zeigt Konformität, Treffer und Extrahierte Daten — wahlweise als Darstellung oder als Raw JSON. Ihre Änderungen speichern Sie in die geladene Konfiguration zurück oder legen sie als neue Konfiguration an. Mehr dazu unter Playground.
Extraktionsvollständigkeit in der Dokumentübersicht
Die Dokumentübersicht kann jetzt anzeigen, wie vollständig ein Dokument
extrahiert wurde. Die Spalte Extraktionsvollständigkeit zeigt das Verhältnis
gefüllter zu vorhandenen Feldern (z. B. 9/12) und warnt, wenn Pflichtfelder
leer sind — der Hinweis nennt die betroffenen Felder. Die Spalte ist nicht
voreingestellt: Sie blenden sie über Tabellenspalten ein, nachdem Sie dort
ein Extraktionsschema ausgewählt haben.
Passend dazu gibt es zwei neue Sortierungen (unvollständigste zuerst bzw.
vollständigste zuerst) und einen Filter auf die Anzahl leerer Pflichtfelder.
Korrigieren Sie Werte im Ergebnisformular, aktualisiert sich die Anzeige.
Die Werte 0 und „Nein" gelten dabei als gefüllt.
Chat: nur noch die Quellen, die die Antwort tragen
Der Chat weist jetzt nur noch die Dokumente als Quelle aus, auf denen die Antwort tatsächlich beruht — statt im Schnitt rund 18 Quellenkarten sind es etwa vier. Findet der Chat nichts Passendes, erscheinen gar keine Quellenkarten mehr statt einer langen Liste ohne Bezug zur Antwort. Außerdem funktionieren Rückfragen: Eine Frage wie „Wenn ja: Wie lautet der genaue Wortlaut?" wird vor der Suche zu einer eigenständigen Frage ergänzt und liefert damit wieder Treffer.
RTF-Dateien hochladen und verarbeiten
Der Upload akzeptiert jetzt auch RTF-Dateien (.rtf). Sie werden wie
Word-Dokumente behandelt: Für die Verarbeitung werden sie automatisch in ein PDF
umgewandelt, danach arbeiten Klassifikation, Extraktion, Zusammenfassung und
Trennung damit wie bei PDFs. Heruntergeladen wird weiterhin die ursprüngliche
RTF-Datei. Die Übersicht der unterstützten Dateitypen finden Sie unter
Erste Schritte.
Text- und Markdown-Dateien hochladen und verarbeiten
Der Upload akzeptiert jetzt auch Text- und Markdown-Dateien (.txt, .md).
Sie werden für die Verarbeitung automatisch in ein PDF umgewandelt; bei Markdown
werden Überschriften, Fettdruck, Listen und Tabellen dabei formatiert
dargestellt. Klassifikation, Extraktion, Zusammenfassung und Trennung arbeiten
damit wie bei PDFs. Heruntergeladen wird weiterhin die ursprüngliche Datei. Die
Übersicht der unterstützten Dateitypen finden Sie unter
Erste Schritte.
Aus „Gruppen“ werden „Fälle“
Das Fallfeature (bisher „Gruppen“) befindet sich weiterhin in der Beta-Phase.
Dokumentgruppen heißen jetzt Fälle: Ein Fall bündelt alle Dokumente zu einem realen Vorgang (z. B. einem Schadensfall oder einem Widerspruch) und wird über seinen Status bis zum Abschluss bearbeitet. Mit der Umbenennung verschwinden auch die Begriffe „Board“ und „Canvas“ aus der Oberfläche: Die bisherige Board-Ansicht ist jetzt einfach die Detailansicht eines Falls. An den Funktionen selbst ändert sich nichts. Ältere Einträge in dieser Übersicht verwenden weiterhin die früheren Bezeichnungen.
Weitere Neuigkeiten
- 2026-08-13 – Chat: Unterhaltung und erste Frage werden gespeichert, bevor die Antwort beginnt — ein Wechsel der Seite verliert den Chat nicht mehr.
- 2026-08-13 – Fälle (Beta): Welche Status als „in Bearbeitung" hervorgehoben werden, lässt sich jetzt je Falltyp festlegen.
- 2026-08-11 – Projekteinstellungen: Der Tab Konfigurationen heißt jetzt Rechnungsabgleich (die Ankündigung in KW 32 verwendet bereits den neuen Namen).
Verbesserungen
- 2026-08-14 – Dokumente, die über die API hochgeladen werden, durchlaufen jetzt dieselbe Verarbeitung wie Uploads in der Oberfläche. In Projekten ohne konfigurierte Workflows blieben sie bisher dauerhaft auf Ausstehend.
- 2026-08-14 – Extrahierte Datumsfelder werden im Ergebnisformular genau so angezeigt, wie sie im Dokument stehen — bisher erschienen sie im US-Format (
8/14/2026). - 2026-08-14 – Dokumente ohne indexierten Inhalt schlagen beim Verarbeiten einmal mit klarer Begründung fehl statt mehrfach ohne Erklärung.
- 2026-08-13 – Schweizerdeutsch: In der Werkzeugleiste der Dokumentansicht fehlte die Beschriftung des Kopiermodus.
- 2026-08-12 – Workflow-Status: Pipeline-Läufe zeigen jetzt die tatsächlich ausgeführten Schritte (z. B. „Klassifizierung + Extraktion") statt nur „Pipeline".
- 2026-08-12 – Tabellenspalten: Eingeklappte Oberfelder zeigen jetzt an, dass darin Felder ausgewählt sind.
August 2026 — KW 32 (3.–9. August)
Chat: Antworten erscheinen live — mit lesbaren Dokumenttiteln
Antworten werden jetzt während der Erstellung angezeigt, statt erst nach ein
bis zwei Minuten am Stück zu erscheinen. Zusätzlich werden Dokumente beim
Einlesen nach Themen zerlegt, und jedes Dokument erhält einen lesbaren Titel:
Quellen heißen jetzt z. B. „Rechnung 880429 Zippel" statt
rechnung_2024_final_v3.pdf. Beides gilt für Dokumente, die nach der Umstellung
eingelesen wurden — ältere Bestände müssen dafür erneut verarbeitet werden.
PowerPoint-Präsentationen hochladen und verarbeiten
Der Upload akzeptiert jetzt auch PowerPoint-Dateien (.ppt, .pptx). Sie
werden beim Hochladen automatisch in ein PDF umgewandelt, wobei jede Folie zu
einer Seite wird. Klassifikation, Extraktion, Zusammenfassung und Trennung
arbeiten damit wie bei PDFs. Im Extraktions-Playground lassen sich jetzt
zusätzlich PowerPoint- und Word-Dokumente testen. Die Übersicht der
unterstützten Dateitypen finden Sie unter Erste Schritte.
Board: Dokumente nach Kategorie, Feld oder Hochladedatum anordnen
Das Gruppenfeature befindet sich weiterhin in der Beta-Phase.
Die Schaltfläche Dokumente anordnen auf dem Board bietet jetzt mehr Anordnungen. Neben den Kategorien einer Klassifizierungsregel können Sie Dokumente nach dem Hochladedatum oder nach einem Feld des Extraktionsschemas gruppieren (z. B. Lieferant oder Rechnungsdatum). Dokumente ohne Wert erscheinen dabei unter „Nicht kategorisiert". Ergänzend gibt es drei Zoom-Aktionen in der Canvas-Leiste: Originalgröße, alles einpassen und ein Dokument einpassen.
PII erkennen und geschwärztes PDF herunterladen
Diese Funktion ist neu, wird projektweise aktiviert und befindet sich noch in einer frühen Phase.
In der Dokumentansicht stehen für PDF-Dokumente zwei neue Aktionen bereit: PII erkennen durchsucht das Dokument nach personenbezogenen Daten und markiert die Fundstellen farbig im Dokument — die Markierungen sind normale Annotationen und lassen sich prüfen, anpassen oder löschen. Geschwärztes PDF herunterladen erzeugt daraus eine PDF-Datei, in der die markierten Stellen dauerhaft geschwärzt sind: Text und Bildpunkte werden entfernt, nicht nur überdeckt.
Verarbeitung im Blick — Fortschritt sehen und stoppen
Solange in einem Projekt noch Dokumente verarbeitet werden, erscheint in der Dokumentübersicht eine Statusleiste. Sie zeigt, wie viele Elemente wartend, laufend, fertig oder fehlgeschlagen sind, und daneben je Workflow (Klassifizierung, Extraktion), wie viel dort noch offen ist. Die Anzeige aktualisiert sich alle paar Sekunden. Mit Verbleibende Verarbeitung stoppen brechen Sie die noch wartenden Elemente ab. Bereits laufende Elemente werden normal beendet, verarbeitete Dokumente behalten ihre Ergebnisse, und Dateien, die noch in Ihrer Upload-Warteschlange liegen, werden verworfen. Abgebrochene Elemente laufen nicht von selbst weiter — Sie können die Verarbeitung später erneut auslösen.
Rechnungsabgleich mit Referenzdaten
Diese Funktion wird projektweise aktiviert.
Die Projekteinstellungen haben einen neuen Tab Rechnungsabgleich. Eine Konfiguration beschreibt, wie Daten aus Ihren Rechnungen mit Ihren Referenzdaten abgeglichen werden: ein Extraktionsschema plus Matcher, die einzelne Schemafelder auf Spalten eines Referenzdatensatzes abbilden. Je Zuordnung legen Sie fest, wie streng verglichen wird (Identifikator, Beschreibend, Numerisch oder Automatisch), dazu Bereich und Treffer-Limit. Konfigurationen lassen sich wahlweise im Formular oder als JSON bearbeiten, duplizieren und löschen; die angezeigte Konfigurations-ID benötigen Sie, um Jobs über die API zu starten. Mehr dazu unter Referenzdaten verwalten.
Weitere Neuigkeiten
- 2026-08-09 – Chat: Die Antwortqualität bleibt auch in großen Projekten stabil; Antworten nennen ihre Quellen mit Titel statt mit einer Nummer.
- 2026-08-08 – Chat: In umfangreichen Projekten werden passende Dokumente zuverlässiger gefunden.
- 2026-08-07 – Chat: Fragen mit Datumsangaben (z. B.
30.07.2026) liefern bessere Treffer. - 2026-08-07 – Dokumentübersicht: Verschachtelte Objektfelder lassen sich als Spalten wählen — beliebig tief; der Spaltentitel zeigt den Pfad, z. B. Adresse > Straße.
- 2026-08-07 – Extraktions-Playground: Beim Speichern eines Schemas lässt es sich direkt als aktives Schema für die Extraktion festlegen — die Option ist vorausgewählt.
- 2026-08-07 – Schema-Builder: Lange Feldbeschreibungen lassen sich über das Stift-Symbol in einem großen Dialog bearbeiten.
- 2026-08-07 – Einstellungen > API Keys: Neben einem neu erzeugten Schlüssel stehen jetzt der API-Endpunkt mit Kopier-Schaltfläche und ein
curl-Beispiel. - 2026-08-07 – Der Rechnungsabgleich steht jetzt in allen Organisationen zur Verfügung.
- 2026-08-06 – Chat: Antworten haben jetzt eine Kopier-Schaltfläche; die Aktionen erscheinen, sobald Sie eine Nachricht überfahren.
- 2026-08-06 – Chat: bessere Treffer bei Abkürzungen, Paragraphen und Aktenzeichen, weniger doppelte Quellen und Dokumentnamen im Antworttext — vor allem bei juristischen Unterlagen.
- 2026-08-05 – Rechnungs-API (
invoice-v2): Das Ergebnis enthält eine Prüfung der Pflichtangaben (DE/AT) mit Status, zugrunde gelegtem Rechtsraum und beanstandeten Feldern. - 2026-08-05 – Konfigurationen ohne Matcher sind zulässig — eine Konfiguration kann damit reine Extraktion ohne Abgleich mit Referenzdaten beschreiben.
- 2026-08-04 – Gruppen (Beta): Eine Gruppe lässt sich über das Kontextmenü (⋮) in der Gruppen-Übersicht umbenennen.
- 2026-08-03 – Board (Beta): E-Mail-Dokumente werden auf dem Canvas als Vorschau dargestellt statt nur als Platzhalter.
- 2026-08-03 – Board (Beta): Der Board-Name steht im Titel des Browser-Tabs.
- 2026-08-03 – Dokumentübersicht: neue Ansicht Listenkarten — Dokumente untereinander mit Vorschaubild, Ordnerpfad, Kategorien, Seitenzahl und Status.
Verbesserungen
- 2026-08-07 – Extraktionsergebnisse: Umlaute und Satzzeichen in Feldbeschriftungen bleiben erhalten — „Straße" wird nicht mehr zu „Strasse".
- 2026-08-07 – Dokumentansicht: Die Playground-Schaltfläche erscheint nur noch bei Dokumenttypen, die der Playground unterstützt.
- 2026-08-06 – Playground: Beim Wechsel des Dokuments oder beim Verlassen der Seite wird eine noch laufende Anfrage abgebrochen — es erscheinen keine Ergebnisse des vorherigen Laufs mehr.
- 2026-08-06 – Extraktion: Ungültige Zahlenwerte (z. B.
NaN) lassen das Speichern eines Ergebnisses nicht mehr fehlschlagen; das betroffene Feld bleibt leer. - 2026-08-06 – Projekteinstellungen: fehlende Beschriftungen im Bereich Workflows ergänzt.
- 2026-08-05 – Schema-Builder: Formular- und JSON-Ansicht bleiben synchron; Feldbeschreibungen gehen beim Wechsel zwischen den Ansichten nicht mehr verloren.
- 2026-08-05 – Das Änderungsdatum von Dokumenten und Datensätzen wird bei Änderungen wieder korrekt fortgeschrieben — die Sortierung nach „zuletzt geändert" stimmt damit wieder.
- 2026-08-05 – Job-API: Serverseitige Fehler beim Anlegen eines Jobs liefern jetzt einen 5xx-Fehler statt einer Eingabe-Fehlermeldung (422); der Job wird dabei zuverlässig als fehlgeschlagen markiert.
Juli 2026 — KW 31 (27.–31. Juli)
Eigenes Logo und App-Name pro Organisation
feld.ai lässt sich jetzt mit dem Branding Ihrer Organisation versehen. Admins finden unter Einstellungen > Branding neue Optionen: ein breites Logo für die Seitenleiste, ein quadratisches Symbol für die eingeklappte Seitenleiste, ein optionales Favicon sowie ein eigener App-Name, der im Browser-Tab-Titel erscheint. Nicht gesetzte Elemente fallen automatisch auf das feld.ai-Standard-Branding zurück; die empfohlenen Bildgrößen werden direkt im Formular angezeigt. Mehr dazu unter Branding.
Vorlagen im Playground
Alle drei Playground-Tabs (Extraktion, Klassifikation, Trennung) haben jetzt eine Schaltfläche Aus Vorlage hinzufügen. Vordefinierte Vorlagen aus Bereichen wie Business, Legal, Healthcare, Finance & Research und Education (z. B. Rechnung, Bestellung, Vertrag) fügen fertige Extraktionsfelder bzw. Regeln ein, die Sie anschließend anpassen können — ein schnellerer Einstieg als bei einem leeren Schema. Dazu kommen ein aufgeräumtes Layout, eine Schaltfläche zum Leeren von Schema bzw. Regeln und ein eigener Dialog für die automatische Schema-Generierung.
Board: Checkliste pro Gruppe
Das Gruppenfeature befindet sich weiterhin in der Beta-Phase.
Auf dem Board einer Gruppe gibt es einen neuen Bereich Checkliste
(unterhalb der Notizen). Ist für den Gruppentyp eine Checklisten-Vorlage
konfiguriert, erscheinen deren Punkte beim ersten Öffnen zum Abhaken; der
Kartentitel zeigt den Fortschritt (z. B. 2/5). Sie können Punkte abhaken,
eigene Punkte ergänzen und beliebige Punkte löschen — der Stand wird pro
Gruppe automatisch gespeichert.
Weitere Neuigkeiten
- 2026-07-29 – Schnellere Extraktion: umfangreiche Extraktionsschemata werden intern in parallele Teilanfragen aufgeteilt — deutlich kürzere Verarbeitungszeiten bei großen Schemata.
- 2026-07-29 – Playground: der ausgewählte Tab wird in der URL gespeichert — geteilte Links öffnen direkt den richtigen Tab.
Verbesserungen
- 2026-07-31 – Board (Beta): Ein Klick auf eine freie Fläche des Canvas hebt eine bestehende Textauswahl wieder auf.
- 2026-07-31 – Klassifikations-Playground: Die Anzeigenamen der Vorlagen sind wieder korrekt ausgerichtet.
- 2026-07-31 – Suche in gescannten Dokumenten: Der Text wird jetzt aus der OCR-Geometrie zeilengetreu rekonstruiert. Die Phrasensuche findet Wortfolgen auch über Zeilen- und Spaltengrenzen hinweg.
- 2026-07-30 – Chat: Vereinzelt in deutschen Antworten auftauchende ostasiatische Schriftzeichen werden vor der Anzeige entfernt.
- 2026-07-30 – Uploads mit sehr langen Dateinamen (über ca. 190 Zeichen) schlagen nicht mehr fehl.
- 2026-07-27 – Geteilte Links auf die Gruppen-Übersicht: der im Link enthaltene Status-Filter bleibt beim Laden jetzt zuverlässig erhalten.
- 2026-07-27 – Playground: beim Wechsel zwischen Dokumenten werden die Ergebnisse des vorherigen Dokuments zurückgesetzt statt weiter angezeigt.
- 2026-07-27 – Referenzdaten: ein Hinweis-Banner, das den neuen Zeilenfilter überlagerte, wurde entfernt.
Juli 2026 — KW 30 (20.–24. Juli)
Filter werden automatisch angewendet
Die Filterleiste kommt ohne separaten Anwenden-Button aus: Sobald eine Filterzeile vollständig und gültig ist, wird der Filter automatisch angewendet. Auswahländerungen (Feld, Operator, Kategorie, Datum) sowie das Hinzufügen oder Entfernen einer Zeile greifen sofort; Texteingaben werden kurz gebündelt, bevor die Liste neu lädt.
Array-Felder im Excel-Export als eigene Zeilen
Array-Felder (z. B. Rechnungspositionen) landeten im Excel-Export der Dokumentliste bisher als kompakter, schwer lesbarer JSON-Text in einer einzigen Zelle. Der Export klappt das erste Array-Feld eines Dokuments jetzt ins Langformat auf: eine Zeile pro Array-Element, wobei die übrigen Spalten je Zeile wiederholt werden. Dokumente ohne Array-Werte erzeugen weiterhin genau eine Zeile — es geht kein Dokument verloren. Damit Sie Array-Felder schon bei der Spaltenauswahl erkennen, sind sie im Spaltenwähler jetzt mit einem Array-Kennzeichen und einem Hinweis markiert.
Weitere Neuigkeiten
- 2026-07-24 – Dokumentansicht: Systeminformationen und Dokument-Metadaten sind in einem gemeinsamen, einklappbaren Bereich zusammengefasst; Admins sehen zusätzlich, wer das Dokument hochgeladen hat.
- 2026-07-24 – Referenzdaten-Tabelle: Zeilen lassen sich per Filter eingrenzen.
- 2026-07-23 – Ordner lassen sich per Strg/Cmd-Klick oder mittlerer Maustaste in einem neuen Tab öffnen.
- 2026-07-23 – Der Ordner-Filter merkt sich den eingegebenen Suchtext bei der weiteren Navigation.
- 2026-07-23 – Abgeschnittene Textblöcke zeigen ihren vollständigen Inhalt jetzt als Tooltip.
- 2026-07-21 – Der Schema-Builder unterstützt jetzt den Feldtyp Integer als eigene Auswahl.
- 2026-07-20 – Für noch nicht klassifizierte Dokumente ist die Aktion zum Klassifizieren jetzt deutlicher sichtbar.
- 2026-07-20 – Neue Icons im Benutzermenü und in den Einstellungs-Tabs verbessern die Orientierung.
- 2026-07-20 – Aufgeräumtere Kontextmenüs an verschiedenen Stellen.
Verbesserungen
- 2026-07-24 – Schema-Builder: Der primitive Elementtyp von Array-Feldern (z. B. Zahl oder Boolean) bleibt beim Speichern erhalten; das Styling der Typ-Auswahl wurde korrigiert.
- 2026-07-23 – Aus Dokumenten stammendes HTML wird vor der Anzeige serverseitig bereinigt (Sicherheits-Fix).
- 2026-07-23 – Extraktionsschemata mit Punkten im Feldnamen (z. B.
order.orderNumber) werden bei der Verarbeitung korrekt aufgelöst. - 2026-07-22 – Referenzdaten-Upload über die API: klarere Fehlermeldungen, wenn einzelne Datensätze ungültig sind.
- 2026-07-21 – Umfangreiche oder sehr dichte Dokumente führen bei der Extraktion nicht mehr zu dauerhaften Fehlern durch Kontextüberlauf.
Juli 2026 — KW 29 (13.–17. Juli)
Board: Dokumente nach Kategorie gruppieren und hervorheben
Das Gruppenfeature befindet sich weiterhin in der Beta-Phase.
Über die neue Schaltfläche Dokumente anordnen im Board können Sie Dokumente nach einer Klassifizierungsregel gruppieren. Die Karten werden dann in beschrifteten Bereichen angeordnet — nicht zugeordnete Dokumente erscheinen unter „Nicht kategorisiert". Außerdem können Sie ein Dokument in der Seitenliste anklicken, um es auf dem Canvas hervorzuheben: Die Ansicht zoomt auf die entsprechende Karte und markiert sie kurz farblich. Markierte Inhalte lassen sich über eine neue Schließen-Schaltfläche oder die Escape-Taste wieder abwählen.
Dokumente umbenennen
Dokumente lassen sich jetzt direkt in feld.ai umbenennen. Öffnen Sie das
Drei-Punkte-Menü in der Dokumentansicht oder das Kontextmenü in der Dateiliste
und wählen Sie Umbenennen. Im Dialog können Sie den neuen Namen eingeben;
unzulässige Sonderzeichen (/ \ : * ? " < > |) werden dabei automatisch
abgelehnt.
Feedback-Spalten in der Dokumentliste
In der Dokumentliste stehen zwei neue optionale Spalten zur Verfügung: Feedback (zusammengefasste Bewertung) und Feedback-Kommentar (Anmerkungen der Prüfer). Beide Spalten erscheinen, wenn ein Extraktionsschema ausgewählt ist, und werden beim Excel-Export mit berücksichtigt.
Weitere Neuigkeiten
- 2026-07-17 – Chat-Dokumentvorschau: Die Miniaturansichten zeigen jetzt die jeweilige Seitenzahl an.
- 2026-07-17 – Klassifizierungsregeln ohne Kategorien werden erkannt und blockiert — mit klarem Hinweis, statt bei der Klassifikation fehlzuschlagen.
- 2026-07-16 – Breadcrumb-Navigation im Playground-Header zeigt den Pfad zum aktuellen Projekt und Tab.
- 2026-07-16 – Beschreibungsfeld im Schema-Builder lässt sich per Klick auf- und zuklappen, um längere Texte bequemer zu bearbeiten.
- 2026-07-15 – Trennungs-Playground: neuer Modus-Schalter Automatisch/Regeln — im Modus Automatisch erkennt das Modell Teildokumentgrenzen, Typen und Bezeichner ohne Regeln; automatisch erkannte Typen sind im Ergebnis mit ✦ markiert. Mehr dazu unter Playground > Trennung testen.
- 2026-07-14 – Systeminformationen (Dateityp, Größe, Seitenanzahl, Hochladedatum) werden im Info-Tab der Dokumentansicht angezeigt.
- 2026-07-14 – JSON-Felder in der Ergebnisansicht werden jetzt mit formatierter Syntaxhervorhebung dargestellt.
Verbesserungen
- 2026-07-17 – Extraktionsfelder mit Punkten im Namen (z. B.
invoice.number) werden jetzt korrekt in den Dokumentergebnissen angezeigt.
Juli 2026 — KW 28 (6.–10. Juli)
Neue Begriffe in der Klassifikation: Klassifizierungsregel und Kategorie
Die Klassifikation verwendet ab sofort klarere Begriffe. Der Container, der eine Menge möglicher Werte bündelt, heißt jetzt Klassifizierungsregel (bisher „Label Set"). Der einzelne Wert, den ein Dokument erhält – etwa „Rechnung" –, heißt jetzt Kategorie (bisher „Label"). Merksatz: Eine Klassifizierungsregel ordnet Dokumente in Kategorien ein. Die Umbenennung betrifft nur die Beschriftungen in der Oberfläche – Ihre bestehenden Regeln, Kategorien und Klassifizierungen bleiben unverändert.
Konfidenzwert der Klassifikation im Playground
Wenn Sie ein Dokument im Klassifikations-Playground testen, zeigt feld.ai jetzt zusätzlich einen Konfidenzwert für die zugewiesene Kategorie an. Der Wert leitet sich aus der Sicherheit des Modells ab und hilft einzuschätzen, wie verlässlich eine Zuordnung ist. Er erscheint ausschließlich im Playground; an regulär verarbeiteten Dokumenten ändert sich nichts.
JSON-Editor im Extraktions-Playground
Im Extraktions-Playground lässt sich JSON jetzt in einem vollwertigen Code-Editor mit Syntaxhervorhebung und Zeilennummern bearbeiten. Das erleichtert das Anlegen und Anpassen von Schemata gegenüber einem einfachen Textfeld.
Eingebettete Bilder in E-Mails
Bei E-Mail-Dokumenten zeigt feld.ai eingebettete Bilder (Inline-Anhänge) jetzt als Vorschau an, statt sie nur als Datei aufzuführen. Der Bildinhalt erscheint dabei in einem eigenen Vorschaubereich.
Filter „hat einen Wert" / „hat keinen Wert" erkennt leere Felder
Extraktionsfelder ohne Inhalt wurden bisher teils als leerer Text statt als echter Leerwert gespeichert. Dadurch erfasste der Filter „hat einen Wert" fälschlich auch leere Felder und „hat keinen Wert" übersah sie. Beide Filter behandeln leere Felder jetzt korrekt als „kein Wert".
Mehrere Dokumente gemeinsam zu einer Gruppe hinzufügen
Das Gruppenfeature befindet sich weiterhin in der Beta-Phase.
In der Dokumentliste können Sie über die Mehrfachauswahl jetzt mehrere Dokumente auf einmal zu einer Gruppe hinzufügen – entweder zu einer bestehenden Gruppe oder als neue Gruppe aus der Auswahl. Bisher war „Zu Gruppe hinzufügen" nur je Einzeldokument möglich.
Board: Scrollen per Mausrad und Dokumente entfernen
Das Gruppenfeature befindet sich weiterhin in der Beta-Phase.
Auf dem Board einer Gruppe können Sie jetzt per Mausrad vertikal und horizontal scrollen; das Scrollen wurde flüssiger und die Anordnung der Inhalte weiter verbessert. Außerdem lässt sich ein Dokument nun direkt über eine Aktion wieder vom Board entfernen.
Alle Änderungen
- 2026-07-10 – Gruppen-Autofill: verschachtelte Extraktionswerte (z. B. Mandant) werden jetzt korrekt in Gruppenfelder und den Gruppennamen übernommen.
- 2026-07-09 – Dokumentvorschau im Dialog wird nicht mehr beschnitten.
- 2026-07-08 – Große Dateien: klarere Fehlermeldung, Hinweis auf unterstützte Dateitypen und vereinheitlichtes Upload-Limit (100 MB).
- 2026-07-08 – Ruhigerer Ladezustand für die Kategorie-Filter-Chips in der Ordneransicht.
- 2026-07-07 – Natürliche Sortierung der Projektordner.
- 2026-07-06 – Geteilte Links auf der Gruppen-Übersicht berücksichtigen den Status-Filter.
Juni/Juli 2026 — KW 27 (29. Juni – 3. Juli)
Dokumentenstapel automatisch in Einzeldokumente auftrennen
Diese Funktion ist neu und befindet sich noch in einer frühen Phase.
Der Playground hat einen neuen Tab Trennung. Damit prüfen Sie, wie das Modell lange PDFs, die mehrere aneinandergehängte Dokumente enthalten (z. B. einen eingescannten Stapel aus Rechnungen und Verträgen), in Teildokumente auftrennt. Sie definieren Trennungsregeln mit Name, Beschreibung und einem Bezeichner (z. B. Rechnungsnummer): Das Modell erkennt dann nicht nur die Grenzen zwischen unterschiedlichen Dokumenttypen, sondern trennt auch gleichartige Dokumente anhand wechselnder Bezeichner-Werte — etwa zwei aufeinanderfolgende Rechnungen mit unterschiedlicher Nummer. Während der Verarbeitung zeigt eine Fortschrittsanzeige den aktuellen Schritt und eine Restzeit-Schätzung. Mehr dazu unter Playground > Trennung testen.
Dokumentliste als Excel exportieren
Über eine neue Export-Aktion in der Dokumentliste laden Sie die aktuell
gefilterten Dokumente als Excel-Datei (.xlsx) herunter — inklusive der
eingeblendeten Extraktionsfeld-Spalten. So lassen sich extrahierte Werte
direkt in Excel weiterverwenden. Der Export folgt exakt dem aktuellen Filter
(inklusive Ordner und Verarbeitungsstatus); bei mehr als 2 000 Dokumenten
werden Sie gebeten, den Filter einzugrenzen.
Chat-Quellen nach Dokument gruppiert
Verweist eine Chat-Antwort auf mehrere Stellen desselben Dokuments, werden diese jetzt unter einem aufklappbaren Eintrag zusammengefasst statt einzeln aufgelistet — die Zählung nennt die Anzahl der Dokumente statt der einzelnen Fundstellen. Außerdem erhalten Dokumente in den Quellen einen kurzen, automatisch erzeugten Titel statt eines Dateinamens oder einer ID, und die Vorschaubilder der Quellen laden wieder zuverlässig.
TIFF-Dateien hochladen
Der Upload akzeptiert jetzt auch TIFF-Dateien, einschließlich mehrseitiger Scans. Sie werden beim Hochladen automatisch in ein PDF umgewandelt und durchlaufen die bewährte PDF-Verarbeitung; Seitenanzahl und Inhalt bleiben dabei erhalten.
Rolle beim Einladen festlegen
Beim Einladen neuer Nutzer lässt sich jetzt direkt die Organisationsrolle festlegen — Admin oder Member (Standard: Member).
Dokumente direkt aus der Übersicht klassifizieren
In der Dokumentansicht öffnet die Klassifizierung jetzt einen Dialog direkt aus dem Übersichts-Tab — ohne Wechsel in den Klassifizierungs-Tab. Der Dialog zeigt alle Klassifizierungsregeln mit ihren Kategorien; über ein Suchfeld filtern Sie nach Kategorien, und passende Klassifizierungsregeln klappen automatisch auf.
Board: Inhalte auswählen, Notizen und Dokumente verwalten
Das Gruppenfeature befindet sich weiterhin in der Beta-Phase.
Das Board einer Gruppe wurde weiter ausgebaut. Sie können Text jetzt direkt aus der Dokumentvorschau auf dem Board markieren und kopieren, pro Gruppe eine Notiz hinterlegen (wird automatisch gespeichert) und einzelne Dokumente wieder vom Board entfernen. Der Zoom auf dem Board reicht jetzt von 50 % bis 500 %.
Alle Änderungen
- 2026-07-03 – Gruppen (Beta): eine Gruppe lässt sich jetzt über die Gruppen-Übersicht löschen; die zugeordneten Dokumente bleiben dabei im Projekt erhalten.
- 2026-07-03 – Veraltete Einzeldokument-Endpunkte für Zusammenfassungen entfernt (nur die Job-API bleibt bestehen).
- 2026-07-02 – Die Spaltenauswahl der Dokumentliste liegt jetzt in einem eigenen Dialog.
- 2026-06-29 – Gruppen (Beta): vorerst auf PDF-Dokumente beschränkt.
Juni 2026 — KW 26 (22.–28. Juni)
Board mit Dokument-Canvas
Das Gruppenfeature befindet sich aktuell noch in der Beta-Phase.
Die Detailansicht einer Dokumentgruppe ist jetzt ein Board: ein eigener Kopfbereich mit Statuswechsel, einklappbare Karten für Felder, Aktivität und Notizen sowie eine durchsuch- und sortierbare Dokumentliste. Rechts zeigt ein Dokument-Canvas eine Seitenvorschau pro Gruppendokument — mit Seitennavigation und Zoom-/Einpassen-Steuerung, sodass Sie alle Dokumente einer Gruppe prüfen können, ohne das Board zu verlassen.
Nach Upload-Datum filtern
In der Filterleiste lässt sich jetzt zusätzlich nach dem Upload-Datum filtern. Für Datumsfelder erscheint automatisch ein Datumsauswahl-Feld, sodass Sie Dokumente z. B. ab oder bis zu einem bestimmten Tag eingrenzen können.
Alle Änderungen
- 2026-06-26 – Extraktion großer Dokumente: eine mögliche Endlosschleife bei der Metadaten-Verankerung sehr langer Textwerte wurde behoben.
- 2026-06-26 – Playground: der geladene Schema-Chip wird jetzt entfernt, sobald der Editor einen ungespeicherten lokalen Entwurf enthält.
- 2026-06-25 – Dokumentliste: über die Mehrfachauswahl lassen sich mehrere Dokumente in einem Dialog gemeinsam einer Kategorie zuweisen.
- 2026-06-25 – Dokument aus der Vollansicht in einen Ordner verschieben: ein neues Aktionsmenü verschiebt das Dokument direkt; der Ordnerpfad oben wird automatisch aktualisiert.
- 2026-06-25 – Chat-Quellen zeigen jetzt zusätzlich den Ordner an, in dem das verlinkte Dokument liegt — so ist erkennbar, woher eine Antwort stammt.
- 2026-06-24 – Ergebnis-Formular: Änderungen werden jetzt auch beim Verlassen der Ansicht gespeichert, nicht erst beim Verlassen des Feldes.
- 2026-06-23 – OCR-Ausweichlösung: PDFs mit Symbol-/Icon-Schriften (z. B. Wingdings, PowerPoint-Exporte) lieferten bisher unbemerkt leeren Text; sie werden jetzt erkannt und automatisch per OCR neu eingelesen.
- 2026-06-22 – Extrahierte Werte: leere Array-Ergebnisse werden jetzt korrekt behandelt.
Juni 2026 — KW 25 (15.–19. Juni)
Größere Dokumentvorschau auf Dateikarten
Die Vorschau auf einer Dateikarte öffnet sich jetzt in einem deutlich größeren Modal mit hochauflösendem Bild. So lassen sich Dokumente direkt aus der Übersicht bequem prüfen, ohne sie vollständig öffnen zu müssen.
Ordner durchsuchen beim Verschieben
Der Dialog zum Verschieben von Dateien in einen Ordner hat jetzt ein Suchfeld. Bei vielen Ordnern finden Sie das Ziel per Texteingabe (mit Tippverzögerung), statt durch die gesamte verschachtelte Struktur zu scrollen.
Alle Änderungen
- 2026-06-19 – Gruppen: Mitgliederliste lässt sich nach Name und Hinzufügedatum sortieren (Standard: zuletzt hinzugefügt zuerst).
- 2026-06-18 – Klassifizierungs-Facetten: der ein-/ausgeklappte Zustand wird jetzt lokal gespeichert.
Juni 2026 — KW 24 (8.–13. Juni)
Inhalt direkt aus der Dokumentvorschau kopieren
In der Dokumentansicht können Sie jetzt Text direkt aus der Vorschau markieren und kopieren. Ein Auswahlrahmen folgt dem Cursor, eine Anzeige zeigt die Anzahl der markierten Wörter, und mit Esc heben Sie die Auswahl wieder auf.
Formularfelder mit der Dokumentstelle verknüpfen
Beim Bearbeiten von Extraktionsergebnissen wird jetzt beim Fokussieren eines Formularfelds die zugehörige Stelle im Dokument hervorgehoben. Die visuelle Verankerung extrahierter Werte greift damit auch im Ergebnisformular — nicht mehr nur im Playground.
Name-Pflicht beim Speichern aus dem Playground
Beim Speichern eines Schemas aus dem Extraktions-Playground werden Sie jetzt nach einem Namen gefragt. Inhaltsgleiche Schemata werden nicht mehr automatisch zusammengeführt — ein bewusst benanntes Schema wird immer angelegt.
Robustere Rechnungsextraktion bei langen Dokumenten
Wenn die Einzeldurchlauf-Extraktion bei sehr langen Rechnungen (viele Positionen) an die Token-Grenze stößt, wechselt die Verarbeitung jetzt automatisch auf die agentische Strategie, statt den Auftrag fehlschlagen zu lassen.
Alle Änderungen
- 2026-06-12 – Beim Hinzufügen eines neuen Extraktionsfeldes wird direkt das erste Eingabefeld fokussiert.
- 2026-06-10 – Eingefügte E-Mail-Adressen werden jetzt von umgebenden Leerzeichen bereinigt.
Juni 2026 — KW 23 (1.–7. Juni)
Extraktionsschemata löschen
Nicht mehr benötigte Extraktionsschemata lassen sich jetzt löschen. Ein Bestätigungsdialog warnt, wenn am Schema bereits Ergebnisse hängen — beim Löschen werden die zugehörigen Datensätze mit entfernt. Das aktuell aktive Schema ist gegen versehentliches Löschen geschützt.
Zeilen in Tabellen-Ergebnissen hinzufügen und entfernen
In tabellarischen Extraktionsergebnissen können Sie jetzt einzelne Zeilen direkt im Ergebnisformular ergänzen oder löschen — praktisch, wenn das Modell eine Position übersehen oder zu viel erkannt hat.
Farbauswahl für Kategorie-Farben
Beim Anlegen und Bearbeiten von Kategorien steht jetzt ein Farbwähler zur Verfügung. Sie wählen die Kategorie-Farbe bequem aus einer Palette, statt einen Hex-Wert einzutippen (die manuelle Eingabe bleibt möglich).
Metadaten optional zurückgeben
In den Extraktionseinstellungen gibt es jetzt eine separate Option, ob zusätzliche Metadaten (z. B. die visuelle Verankerung) mit zurückgegeben werden. Sie ist standardmäßig deaktiviert und unabhängig von der gewählten Extraktionsstrategie schaltbar.
Alle Änderungen
- 2026-06-04 – Nicht lesbare oder defekte PDFs werden jetzt als klar benannter, dauerhafter Fehler gemeldet statt mit dem generischen „Indexierung fehlgeschlagen".
- 2026-06-04 – Ungültige Suchfilter (z. B. „enthält" auf einem ID-Feld) liefern jetzt einen klaren 400-Fehler statt eines generischen Serverfehlers.
- 2026-06-03 – Extraktionsergebnisse tragen jetzt einen Konfidenzwert (Modellsicherheit) in den Metadaten.
- 2026-06-01 – Projektsuche: Unterabfragen sind jetzt korrekt auf das jeweilige Projekt eingegrenzt.
Mai 2026 — KW 21/22 (22.–31. Mai)
Dokumentgruppen (Vorgänge / Akten / Kunden)
Neu sind Dokumentgruppen: Gruppen eignen sich für verschiedene Gruppierungen von Dokumenten anhand von Kunden, Vorgängen oder Adressen. Diese Gruppierungen sind virtuell und unabhängig von der Ordnerstruktur im Projekt. In einem eigenen Projektbereich lassen sich Dokumente zu Gruppen bündeln und nach Typ, Status und Bearbeiter filtern. Eine Übersichtstabelle zeigt alle Gruppen, eine Detailseite den Statusverlauf, die gruppenbezogenen Felder und die zugeordneten Dokumente. Aus der Dokumentansicht heraus lässt sich ein Dokument einer Gruppe zuordnen. (Die Funktion wird projektweise aktiviert und befindet sich aktuell noch in der Beta-Phase.)
Favoriten-Projekte
Projekte lassen sich jetzt als Favoriten markieren und erscheinen dann oben in der Projektliste. Die Auswahl wird lokal im Browser gespeichert.
Avatar-Farbe im Profil
Im Profil können Sie jetzt eine Farbe für Ihren Avatar aus einer Palette wählen — der Avatar erscheint mit dieser Farbe im Benutzermenü und im Profil.
„Automatisch" wählt Einzeldurchlauf oder agentisch
Die Extraktionsstrategie Automatisch verarbeitet kurze Dokumente (bis 6 Seiten) jetzt in einem schnellen Einzeldurchlauf und längere Dokumente agentisch. Die Option Gründlich entspricht jetzt der agentischen Verarbeitung.
Extraktionsspalten erscheinen automatisch bei Filtern
Wenn Sie nach einem Extraktionsfeld filtern, wird die zugehörige Spalte in der Dokumenttabelle jetzt automatisch eingeblendet. So sehen Sie den gefilterten Wert sofort, ohne ihn erst über den Spaltenwähler aktivieren zu müssen. Entfernen Sie den Filter, verschwindet die Spalte wieder.
Bessere Chat-Antworten durch neues Reranking
Der Chat nutzt jetzt einen neuen, selbst gehosteten Reranker für die Auswahl der relevantesten Dokumentstellen. Damit liefert die Chat-Suche wieder zuverlässig passende Treffer.
Alle Änderungen
- 2026-05-31 – Passwort-Zurücksetzen ist jetzt für noch nicht abgeschlossene Einladungen blockiert (Sicherheits-Fix).
- 2026-05-28 – Klassifizierungs-Facetten: deutlichere Ladeanzeige.
- 2026-05-22 – Zugewiesene Kategorien werden in der Dokumentansicht jetzt sortiert angezeigt.
Mai 2026 — KW 20/21 (14.–22. Mai)
Volltextsuche im Dokumentinhalt
In der Filterleiste steht jetzt das neue Feld Inhalt zur Verfügung — Sie können damit direkt nach Text innerhalb Ihrer Dokumente suchen, nicht nur über Metadaten und Klassifizierungen. Treffer in Anhängen (z. B. eine PDF in einer E-Mail) zeigen automatisch das zugehörige Top-Level-Dokument. Die Suche bleibt auch auf großen Projekten schnell; sehr lange Segmente (> 1 MB / Excel-Dateien) werden ausgespart, um Spitzenlast beim Indexaufbau zu vermeiden. Der Inhalt eines Dokumentes ist in diesem Fall der bereits beim Upload durch OCR-ähnliche Modelle effizient extrahierte Text.
Visuelle Verankerung extrahierter Werte
Bei der Auto-Extraktion ist jetzt für jedes Feld sichtbar, wo im Dokument
der Wert gefunden wurde. Im Playground erscheinen extrahierte Felder mit
grünem Rahmen — ein Klick darauf springt direkt zur passenden Stelle in der
PDF-Vorschau. Im Hintergrund nutzt die Extraktion jetzt OCR-Referenzen
(z. B. T1:A2) statt den Text neu zu generieren: das eliminiert eine ganze
Klasse von Transkriptionsfehlern. Die Bounding-Boxen
werden aus denselben Referenzen abgeleitet — eine separate Lokalisierungs-Anfrage
an das VLM entfällt.
Schema-Builder: schneller und stabiler
Der Schema-Builder in Playground und Projekteinstellungen reagiert deutlich flüssiger — insbesondere bei Schemata mit vielen Feldern und beim Wechsel zwischen Dokumenten-Tabs. Außerdem wurden mehrere Bearbeitungs-Fehler behoben: die JSON-Textarea wird beim Tippen nicht mehr geleert, das Umbenennen eines Feldschlüssels lässt das Feld nicht mehr verschwinden, und leere Beschreibungen werden beibehalten. Die Formularzeilen sind zudem etwas kompakter.
Dateien zwischen Ordnern verschieben
Über die Aktionsmenüs auf Dokumentkarten, Ordnerkarten und in der Mehrfachauswahl steht jetzt eine Verschieben-Aktion bereit. Ein neuer Dialog zeigt alle verfügbaren Projektordner zur Auswahl, inklusive verschachtelter Struktur.
Schema-Namen in der Extraktionsauswahl
Extraktionsschemata erhalten ein optionales, frei wählbares Name-Feld,
das in der Schema-Tabelle und im Schema-Dropdown (Projekteinstellungen >
Extraktion, Playground) angezeigt wird. So lassen sich Schemata leichter
auseinanderhalten, ohne den JSON-Schema-title (LLM-Artefakt) zu verändern.
Schemata-Namen müssen nicht mehr eindeutig sein — zwei Schemata mit dem
gleichen Anzeigenamen kollidieren nicht.
Konfigurierbare Spalten in der Dokumenttabelle
Die Dokumenttabelle hat einen neuen Spaltenwähler: Sie können Standardspalten ein- und ausblenden und zusätzlich beliebige Felder aus dem Extraktionsschema des Projekts als eigene Spalte anzeigen. So sehen Sie extrahierte Werte direkt in der Übersicht. Die Spaltenauswahl wird pro Projekt lokal gespeichert.
Alle Änderungen
- 2026-05-21 – Chat scrollt bei neuen Nachrichten automatisch nach unten.
- 2026-05-21 – Suchanfragen zeigen einen deutlich klareren Lade-/Disabled-Status, während die Filter neu laden.
- 2026-05-18 – API-Keys in der Tabelle werden jetzt stabil sortiert.
- 2026-05-18 – Bessere Lade-Anzeige für die Dokumentansicht beim ersten Aufruf.
- 2026-05-14 – Chat: Dokument lässt sich aus dem Chat-Header direkt in einem neuen Tab öffnen.
Mai 2026 — KW 20 (11.–13. Mai)
Suche über alle Extraktionsschemata
Die Filterleiste zeigt jetzt Felder aus allen Extraktionsschemata eines
Projekts — bisher waren nur Felder von bestimmten Ergebnistypen sichtbar. So
lassen sich Dokumente auch über Zwischenergebnisse hinweg filtern. Das
Operator-Dropdown zeigt zusätzlich nur die für den jeweiligen Feldtyp
passenden Operatoren an (Text: enthält; Zahl/Datum: >, <; UUID: ==),
und ist leer/ist nicht leer auf numerischen oder Datumsfeldern führt
nicht mehr zu einem Fehler.
Liste aller Feedback-Kommentare pro Ergebnisdatensatz
Zu jedem extrahierten Datensatz sehen Sie jetzt sämtliche Feedback-Einträge inklusive Autor, Bewertungstyp und Datum — bisher war nur das eigene Feedback sichtbar. So lässt sich auf einen Blick nachvollziehen, wer wann was zum Ergebnis angemerkt hat; eigene Einträge sind weiterhin separat kenntlich gemacht und können bearbeitet werden.
Chat: Entwürfe pro Chat und überarbeitete Vollansicht
Halbfertige Nachrichten werden jetzt pro Chat als Entwurf gespeichert — beim Wechsel zwischen Chats geht nichts mehr verloren. In der Chat-Vollansicht liegt die Dokumentvorschau jetzt links und der Chat-Verlauf rechts; der aktuell ausgewählte Dokumenten-Link in der Antwort wird hervorgehoben, sodass Sie auf einen Blick wissen, welches Dokument gerade angezeigt wird. Daneben viele kleinere Layout-, Abstands- und Feedback-Anpassungen (Daumen hoch/runter).
Ergebnisformular speichert automatisch
Im Bearbeitungsformular für Extraktionsergebnisse entfällt der Speichern-Button: Änderungen werden beim Verlassen eines Feldes oder kurz nach der letzten Eingabe automatisch gespeichert. Eine Statusanzeige oberhalb des Formulars zeigt jederzeit, ob alles gespeichert ist, gerade gespeichert wird oder ein Fehler aufgetreten ist.
Klare Rückmeldung bei leeren Extraktionsschemata
Schemata ohne definierte Felder werden jetzt im Schema-Dialog, im Playground
und über die API einheitlich als ungültig zurückgewiesen — bisher liefen
solche Extraktionen ins Leere. Neue Schemata starten als leeres Objekt
({}) statt mit einem nicht-gültigen Platzhalter, und im Playground erklärt
ein Hinweis, warum „Run Extraction" deaktiviert ist, solange noch kein Feld
definiert wurde.
Alle Änderungen
- 2026-05-13 – Extraktions-Formular: bessere Gruppierung, ruhigere Icons und konsistente Abstände.
- 2026-05-12 – Projektliste: zuletzt gewählte Sortierreihenfolge bleibt zwischen Sitzungen erhalten.
- 2026-05-12 – Dokument-ID kopieren ist aus den primären Aktionen verschwunden und nur noch über das Kontextmenü erreichbar — räumt die Dokumentkarte auf.
- 2026-05-12 – Indexierungs-Wartezeit zwischen Retries skaliert jetzt exponentiell — weniger unnötige Last bei kurzen Verzögerungen.
- 2026-05-11 – Nachklassifizierung: fehlgeschlagene Dokumente erscheinen jetzt als Warnsymbol mit Anzahl am Play-Button der Klassifizierungsregel; ein erneuter Klick stellt sie wieder in die Warteschlange (Warnung verfällt automatisch nach einer Stunde).
- 2026-05-11 – Seitenleiste: ein- und ausklappen mit deutlicheren Icons, Hover-Button auf der eingeklappten Leiste und kleinere visuelle Korrekturen.
Mai 2026 — KW 19 (4.–8. Mai)
Excel-Tabellen automatisch extrahieren
Die Auto-Extraktion versteht jetzt auch Excel-Dateien. Anstatt jede Seite linear
zu verarbeiten, navigiert ein Agent gezielt durch die Sheets: Spalten und
Stichproben sind ihm bekannt, und er kann gefiltert nach Zeilen suchen, Spalten
zusammenfassen oder Werte aggregieren — passend für Stücklisten, Tabellen mit
vielen Zeilen oder verschachtelte Auswertungen. Für kleine Excel-Dateien greift
automatisch eine schnellere Variante. Extrahierte Werte tragen die Excel-Zelle
(z. B. B14) als Quelle.
Live-Fortschritt im Playground
Während eine Extraktion im Playground läuft, sehen Sie jetzt den aktuellen Schritt (Inhaltsverzeichnis aufbauen, Sektionen extrahieren) und für längere Dokumente eine Restzeit-Schätzung. So wissen Sie auf einen Blick, wo das Modell gerade steht, statt auf den finalen Spinner zu warten.
Dokumentnavigation am Scroll-Rand
Beim Scrollen am oberen oder unteren Rand einer Dokumentseite springt die Ansicht jetzt automatisch zur vorherigen oder nächsten Seite — das durchgängige Lesen langer Dokumente wird flüssiger und Sie müssen nicht mehr aktiv blättern.
Filterleiste aufgeräumt
- Klassifizierungs-Chips ohne Treffer werden eingeklappt. Ein +N weitere-Chip pro Klassifizierungsregel öffnet sie wieder — so bleibt die Filterleiste auch bei vielen Kategorien übersichtlich, und Kategorien ohne Treffer lassen sich weiterhin auswählen.
- Sehr große Mengen an Kategorien werden gruppiert und sind pro Klassifizierungsregel ein- und ausklappbar.
- Auf Dokumentkarten werden maximal 2 Klassifizierungs-Chips angezeigt; aktiv gefilterte Kategorien bleiben automatisch sichtbar.
Facetten-Zähler aktualisieren sich über alle Klassifizierungsregeln
Wenn Sie über mehrere Klassifizierungsregeln gleichzeitig filtern, zeigen die Facetten-Zähler in der Filterleiste jetzt immer die korrekt gefilterte Anzahl an. So sehen Sie auf einen Blick, wie viele Dokumente bei einer Kombination von Filtern übrig bleiben.
Klassifizierung in der Dokumentansicht aufgeräumt
Bestehende Klassifizierungen erscheinen jetzt als Kategorie-Chips direkt im Header der jeweiligen Klassifizierungsregel — die separate Liste oberhalb entfällt. Ein Klick auf eine Kategorie in der Klassifizierungsregel toggelt die Zuweisung: nicht gesetzte werden zugewiesen, gesetzte entfernt. Der Edit-Button im Overview-Panel springt direkt in den passenden Klassifizierungsregel-Tab.
Feedback zu Extraktionsergebnissen
Zu jedem extrahierten Datensatz lässt sich jetzt direkt in der Ergebnisansicht Feedback hinterlegen — z. B. ein Kommentar, was am Ergebnis nicht stimmt oder besonders gut funktioniert hat. Eigene Einträge können nachträglich bearbeitet oder gelöscht werden.
Alle Änderungen
- 2026-05-08 – Klassifizierungen mit Einzelauswahl zeigen jetzt Radio-Icons statt Checkboxen — der Charakter „nur eine Option" wird damit auf einen Blick erkennbar.
- 2026-05-08 – Auto-Extraktion (Excel): präzisere Tool-Beschreibungen für den agentischen Schritt.
- 2026-05-07 – Excel-Auto-Extraktion mit agentischer Sheet-Navigation; Optimierungen für Spalten-Sampling und Konsolidierung.
- 2026-05-07 – Dokumente, die während der Verarbeitung gelöscht werden, führen nicht mehr zu Folgefehlern.
- 2026-05-06 – Excel-Indexer: Behandlung von Abbildungen und besuchter Seiten korrigiert.
- 2026-05-05 – Chat lässt sich jetzt auch direkt im Chat-Header umbenennen und löschen — bisher ging das nur über das Kontextmenü in der Seitenleiste.
- 2026-05-05 – Projekt-Dokumentfilter werden beim Verlassen der Ansicht zuverlässig zurückgesetzt.
- 2026-05-05 – Backfill-Queue-Status wird bei Task-Ende (Erfolg, Fehler, Abbruch) zuverlässig aktualisiert.
- 2026-05-04 – Auto-Klassifizierung: automatischer Wiederholungsversuch bei vorübergehenden LLM-Fehlern.
- 2026-05-04 – Auto-Extraktion: Behandlung von Token-Limits und Array-Feldern verbessert.
- 2026-05-04 – Suchfilter: ungültige Eingaben liefern jetzt klare 400-Fehler statt generischer Serverfehler.
April 2026 — KW 18 (27. April – 1. Mai)
Neue Extraktionsstrategie „Automatisch"
Die Extraktionsstrategie heißt jetzt standardmäßig Automatisch und ergänzt die bestehenden Optionen Einfach und Gründlich. Sie wählt für jedes Dokument die passende Methode: für kurze Dokumente eine schnelle Verarbeitung Seite für Seite, für längere Dokumente einen agentischen Ansatz, der zunächst ein Inhaltsverzeichnis des Dokuments aufbaut und dann gezielt durch relevante Sektionen navigiert — schneller und genauer als alle Seiten linear zu verarbeiten. Die Option lässt sich pro Projekt und im Playground einstellen. Mehr dazu unter Auto-Extraktion.
Projekt-Kontext im Chat
Im Chat können Sie jetzt ein Projekt als Kontext auswählen. Antworten beziehen sich gezielt auf die Dokumente dieses Projekts — so müssen Sie nicht mehr zwischen Projekten wechseln, um Fragen im jeweiligen Kontext zu stellen.
Suchanfragen lokal speichern
Such- und Filterabfragen lassen sich jetzt speichern und später mit einem Klick wieder aufrufen. Ideal für wiederkehrende Auswertungen wie „alle offenen Verträge" oder „Rechnungen Q1". Gespeicherte Suchen werden lokal im Browser abgelegt.
Filter auf aktuellen Ordner einschränken
In der Filterleiste lässt sich die Suche jetzt auf den aktuell geöffneten Ordner einschränken statt projektweit zu suchen. Der Ordner-Scope bleibt in den URL-Parametern erhalten — geteilte Links zeigen also wieder genau die gleiche Auswahl.
Alle Änderungen
- 2026-05-01 – Layout der gespeicherten Filter verbessert.
- 2026-04-30 – Vorschau-Größe, Projekteinstellungen-Fix, klarere Lade-Anzeige für Projektdokumente.
- 2026-04-29 – Paginierung und Sortierung bleiben pro Ordner erhalten; neuer „Keine Kategorie"-Chip pro Klassifizierungsregel; kleinere UX-Anpassungen; /facets-Query deutlich schneller bei großen Projekten.
- 2026-04-28 – Persistente Gruppen-Ansicht im Dokument-View; Ordner-Upload zeigt Erfolg/Fehler transparent; Copy-Button auf Extraktionsergebnis-Feldern; Schema-Builder visuell überarbeitet; fehlende Übersetzungen ergänzt; Refetch-Fix für Dokument-Ansicht.
- 2026-04-27 – Dynamischer „Mehr"-Button bei vielen Dokumentfiltern; Loading-State im Schema-Dropdown; Gründliche Extraktion intern optimiert (Metadaten-Grounding und Konsolidierung).
April 2026 — KW 17 (20.–24. April)
Chat-Verlauf verwalten
Ihre Unterhaltungen mit dem KI-Assistenten werden jetzt dauerhaft gespeichert. In der Seitenleiste sehen Sie alle bisherigen Chats, können frühere Gespräche jederzeit wieder öffnen und dort weitermachen. Neue Chats lassen sich direkt starten, bestehende Chats über das Kontextmenü (⋮) umbenennen oder löschen.
Bestehende Dokumente nachextrahieren
Ähnlich wie bei der Nachklassifizierung können Sie jetzt auch die Extraktion für bestehende Dokumente nachträglich anstoßen. In der Schema-Tabelle unter Projekteinstellungen > Extraktion zeigt eine neue Spalte, wie viele Dokumente bereits extrahiert sind. Über den Play-Button starten Sie die Extraktion für die fehlenden Dokumente. Mehr dazu unter Auto-Extraktion.
Extraktionsschema iterativ im Playground entwickeln
Der Playground in der Dokumentansicht teilt jetzt die Schemata des Projekts. Sie können ein bestehendes Schema laden, anpassen und die Änderungen direkt gegen das aktuelle Dokument testen — so lange iterieren, bis das Ergebnis passt, und erst dann speichern. Das System erkennt vorhandene Schemata und vermeidet Duplikate. Mehr dazu unter Playground.
Rollenbasierte Zugriffskontrolle
Organisationen unterscheiden jetzt zwischen Admin- und Member-Rollen. Sensible Bereiche wie Benutzerverwaltung und Organisationseinstellungen sind nur für Admins sichtbar — Members sehen einen entsprechenden Hinweis. Admins können die Rolle eines Mitglieds direkt in der Benutzertabelle ändern. Einladungen neuer Nutzer durch Admins folgen in Kürze.
Thinking-Modus für Extraktion
Bei der Auto-Extraktion kann jetzt ein Thinking-Modus aktiviert werden. Das Modell „denkt" dabei vor der Antwort ausführlicher nach, was bei komplexen Dokumenten zu genaueren Ergebnissen führt. Die Option lässt sich pro Projekt in den Extraktionseinstellungen und im Playground ein- und ausschalten. Mehr dazu unter Auto-Extraktion.
Alle Änderungen
- 2026-04-23 – Projekttabelle: neue Spalte „Erstellt am" und sortierbare Spalten.
- 2026-04-22 – Nachklassifizierung zeigt vor dem Start einen Bestätigungsdialog mit der Anzahl betroffener Dokumente. Bereits laufende Dokumente werden nicht erneut eingereiht.
- 2026-04-22 – Filter-Ansicht: Ausrichtung korrigiert, neuer Button „Alle Filter zurücksetzen" setzt Suchfilter und Kategorie-Facetten gemeinsam zurück.
- 2026-04-21 – Seitenzahl in der Dokumenttabelle wird automatisch aus den Segmenten abgeleitet und nachträglich befüllt.
- 2026-04-20 – Schema-Editor vergrößert (1 100 px breit), JSON-Textarea resizable, mehrzeilige Feldbeschreibungen und neue Felder für Schema-Titel und -Beschreibung.
- 2026-04-20 – Link zur Dokumentation (docs.feld.ai) in Seitenleiste und Benutzermenü hinzugefügt.
- 2026-04-20 – MFA-Anmeldung: OTP-Prüfung wartet korrekt auf verfügbare Faktoren.
- 2026-04-20 – E-Mail-Anhänge mit vielen Bildern werden auf das Seitenlimit begrenzt, um Verarbeitungsfehler zu vermeiden.
- 2026-04-20 – Fehlerhafte PDF-Seiten werden übersprungen; OCR-Fallback greift automatisch.
April 2026 — KW 16 (14.–17. April)
Referenzdaten im Projekt einsehen
Über das Drei-Punkte-Menü (⋮) erreichen Sie den neuen Bereich Referenzdaten. Dort sehen Sie alle via API hochgeladenen Datensätze als Karten, können die Versionshistorie aufklappen und einzelne Versionen direkt im Browser prüfen. Mehr dazu unter Referenzdaten verwalten.
Extraktionsstrategien: einfach oder gründlich
Für die Auto-Extraktion stehen zwei Strategien zur Auswahl: Einfache Extraktion verarbeitet die ersten 3 Seiten eines Dokuments und ist schnell — ideal für Einseiter, Rechnungen und Formulare. Gründliche Extraktion verarbeitet alle Seiten mit höherer Genauigkeit und eignet sich für Verträge, Berichte und umfangreiche Dokumente. Die Strategie lässt sich in den Projekteinstellungen und im Playground einstellen; ein Info-Symbol neben der Auswahl erklärt die Unterschiede direkt im Kontext. Mehr dazu unter Auto-Extraktion.
Alle Änderungen
- 2026-04-16 – Einzelnes Dokument-Ergebnis wird automatisch aufgeklappt, wenn nur ein Ergebnis vorhanden ist.
- 2026-04-13 – Abgelaufene Sitzungen werden zuverlässiger erkannt und automatisch beendet. Wir gehen davon aus, dass damit die häufige Meldung „Es ist etwas schiefgelaufen" in vielen Fällen behoben ist — falls Sie die Meldung weiterhin oft sehen, melden Sie sich bitte bei uns.
- 2026-04-13 – Seiten der Anwendung haben jetzt eindeutige Titel im Browser-Tab (z. B. Projekteinstellungen, API Keys, Profil). So behalten Sie auch bei mehreren geöffneten Tabs den Überblick.
- 2026-04-08 – Datumsextraktion (in Tabellenextraktion) erkennt zweistellige Jahreszahlen im US-Format (z. B.
04/17/26). - 2026-04-02 – Auto-Extraktion erfordert jetzt eine Schemaauswahl, bevor sie aktiviert werden kann.
März 2026
Dokumente schnell nach Kategorien filtern
In der Dokumentenübersicht sehen Sie jetzt alle Kategorien mit der Anzahl zugeordneter Dokumente. Klicken Sie auf eine Kategorie, um die Liste sofort zu filtern — innerhalb einer Klassifizierungsregel mit ODER, zwischen verschiedenen Klassifizierungsregeln mit UND. Mehr dazu unter Suche und Filter.
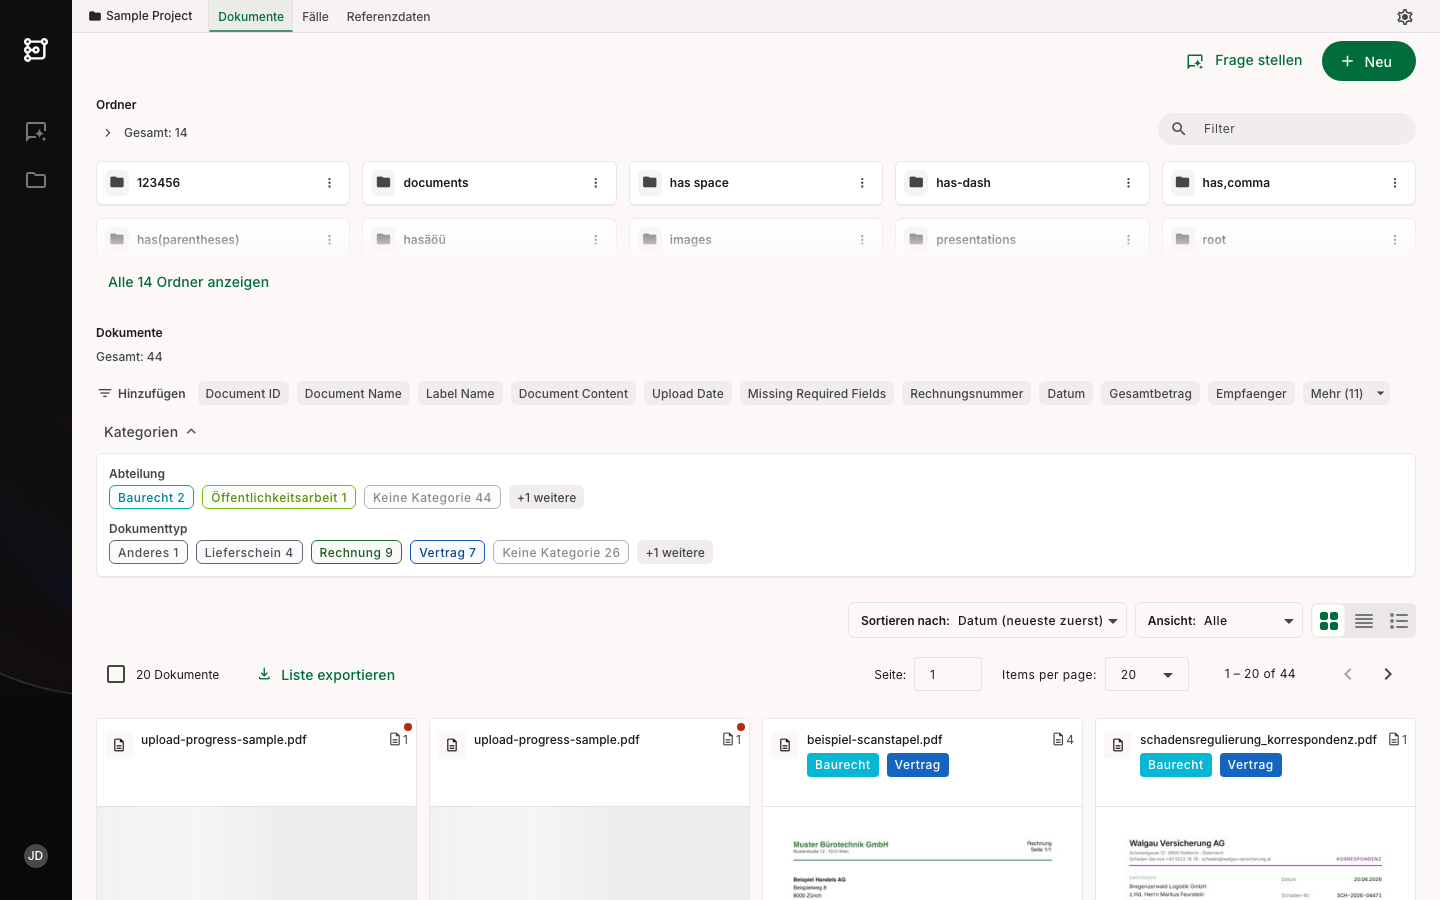
Ordner hochladen
Sie können jetzt ganze Ordner per Drag-and-Drop oder über den Button Ordner hochladen in Ihr Projekt importieren. Die Ordnerstruktur bleibt dabei erhalten — auch bei verschachtelten Unterordnern.
Bestehende Dokumente nachklassifizieren
Klassifizierungsregeln zeigen jetzt, wie viele Dokumente bereits klassifiziert sind (z. B. 7/8).
Über den Play-Button können Sie die fehlenden Dokumente für eine einzelne Klassifizierungsregel
nachträglich klassifizieren lassen.
Mehr dazu unter Auto-Klassifizierung.
Extraktionsschema in den Projekteinstellungen konfigurieren
Sie können Extraktionsschemas direkt in den Projekteinstellungen erstellen, bearbeiten und aktivieren — inklusive eines visuellen Schema-Builders und Raw-JSON-Editor. Zur Anleitung: Auto-Extraktion.